Organisaties zijn nog te vaak besluiteloos over hun enorme verzamelingen documenten: op schijven, in samenwerkingsomgevingen (Microsoft 365!), document management- en zaaksystemen. Ballast van soms wel twintig-dertig jaar is meegesleept in migraties naar de cloud, naar SharePoint Online of – ‘voorlopig’ natuurlijk – geparkeerd in Azure. En ik krijg vaak te horen: we weten dat het vol moet zitten met privacygevoelige gegevens en -documenten, maar we weten niet hoe we er in al die verschillende opslag van af moeten komen. Ook bij extern delen en bij publicatie van documenten, zoals in Woo-verzoeken, speelt aanwezigheid van (bijzondere) persoonsgegevens in inhoud of metadata een belemmerende rol. Oplossingen zijn nog al eens beperkt in scope of platform gebonden of verwerken gegevens op plekken waar we dat liever niet meer doen. Ik had de afgelopen weken een paar goede gesprekken met Peter van Dijk (business developer) en Eric Hoefman (managing director) van EntrD Privacy Solutions.
Wat is FileFactory?
Peter, jullie leveren met DataFactory en FileFactory oplossingen om gegevens in databases en documenten te kunnen traceren daarover rapporteren en gegevens in document en metadata maskeren (zgn. ‘lakken’). We zullen het vandaag vooral over FileFactory hebben. Kan je in het kort vertellen wat de oplossing doet?
Peter van Dijk legt uit dat FileFactory een SaaS (Software as a Service-) oplossing is, gemaakt door EntrD. “Het vindt automatisch gevoelige persoonsgegevens in documenten en documentstromen, analyseert die en ‘schoont het op’, zodat de documenten veilig gebruikt, gedeeld of gearchiveerd kunnen worden.
Eric Hoefman vult aan: “Welke documenten FileFactory verwerkt bepaalt de klant, dit kunnen alle documenten zijn maar ook bijvoorbeeld alleen bepaalde type documenten of documenten die horen bij een specifiek dossier. Concreet doet FileFactory drie dingen: 1. leesbaar maken via OCR (ook gescande pdf’s en afbeeldingen), 2. gevoelige gegevens traceren en 3. die gegevens maskeren of anders behandelen volgens vaste regels.”
Onder traceren verstaat FileFactory automatisch herkennen en lokaliseren van gevoelige informatie in documenten, zoals BSNs, namen, adressen, ID-gegevens of medische termen, inclusief waar ze exact voorkomen (tekst, tabellen, metadata). Met maskeren wordt bedoeld: het onomkeerbaar verwijderen of vervangen van die gevoelige gegevens in het document én in de metadata. “En dit is echte opschoning,” aldus Van Dijk, “dus niet alleen visueel ‘zwartlakken’. Na verwerking is de informatie technisch niet meer aanwezig en ook niet terug te halen via kopiëren, OCR of metadata-analyse. Het resultaat is dan een document dat functioneel bruikbaar blijft, maar geen privacy- of compliance-risico meer vormt.”

Afb. 1: FileFactory kan overweg met o.a. Office documenten, PDF en afbeeldingen
Jullie gaven aan dat FileFactory kan werken in verschillende bronnen, dus rechtstreeks kan koppelen met SharePoint online, DMS’en en fileshares. Kan je daar wat meer over zeggen?
Van Dijk: “Vanuit die bronlocaties worden documenten geselecteerd, opgehaald, opgeschoond en weer automatisch teruggeplaatst op dezelfde plek. Of, als dat nodig is, kan het gepubliceerd worden naar een aparte doelmap of een archief. Hierdoor ontstaat dus geen losse ‘schaduwkopie’, maar wordt het originele document inhoudelijk opgeschoond (zowel tekst als metadata), gecontroleerd en reproduceerbaar verwerkt en structureel vervangen door een veilige versie.” Dat dit een succesvolle oplossing is blijkt onder andere uit toepassing bij woningcorporatie de Alliantie.
Van Dijk legt uit dat het opruimen ook geen eenmalige actie hoeft te zijn. “FileFactory kan zowel eenmalige opschoning uitvoeren van historische archieven, als periodiek nieuwe documenten opschonen, of continu fungeren als ‘poortwachter’ voor nieuwe of gewijzigde bestanden. Op die manier kan documentopruiming onderdeel worden van de ‘dagelijkse procesflow’, in plaats van een eenmalige, losse compliance-actie.
FileFactory voor Wet Open Overheid (Woo)
Dat klinkt voor mij dan ook interessant voor publicatie van documenten in het kader van Woo-verzoeken, kan dat ook?
Van Dijk: “Bij Woo-verzoeken helpt FileFactory overheden om documenten aantoonbaar en consistent op te schonen vóór publicatie, inclusief rapportage en herleidbaarheid van het proces.” Hoefman: “Bovendien integreert Filefactory naadloos met publicatieplatformen zoals iprox.open om documenten na maskeren gemakkelijk te publiceren.“
Gegevensverwerking binnen EU
OK, nu is FileFactory een SaaS oplossing en organisaties willen meer dan ooit weten waar de leverancier is geregistreerd en waar welke gegevens worden verwerkt onder welke condities en normen.
“FileFactory is een Nederlandse SaaS-oplossing waarbij alle documentverwerking binnen Nederland plaatsvindt, conform AVG en ISO/NEN-normen”, aldus Van Dijk.
Meer kenmerken FileFactory
Verwerking op Nederlands grondgebied zal potentiële klanten prettig in de oren klinken, zijn er ook andere features waarmee FileFactory concurrerend is met andere oplossingen?
Van Dijk somt een paar ‘unieke’ kenmerken op:
– “Onomkeerbaarheid: FileFactory verwijdert of vervangt gevoelige gegevens onomkeerbaar uit document én metadata. Het gaat dus om echte opschoning, niet om visuele redactie of alleen classificatie. Metadata-opschoning is inmiddels succesvol toegepast bij een grote Nederlandse overheidsinstantie, in reactie op een publiek gemaakt datalek in overheidsdocumenten in april vorig jaar. Daarbij zijn grote aantallen Woo-documenten opgeschoond om vervuilde metadata onomkeerbaar te verwijderen
– Mutliplatform integratie: directe koppelingen met SharePoint Online, DMS’en en fileshares.
– Schaalbaarheid: geschikt voor kleinere aantallen maar ook voor miljoenen documenten, eenmalig, periodiek of continu, volledig geautomatiseerd en zonder handmatige tussenstappen. Tot op heden zijn meer dan 80 miljoen documenten met FileFactory verwerkt (dit betreft het cumulatieve volume tot recent, waarbij er maandelijks nieuwe documentstromen bijkomen bij bestaande en nieuwe klanten).
– Aanpasbaarheid: organisaties bepalen zelf welke typen gevoelige informatie FileFactory herkent en opschoont.
– Consistentie: documenten worden telkens volgens dezelfde regels opgeschoond, met inzicht in wat is aangepast en waarom. Dat maakt het proces uitlegbaar richting audits én werkbaar in dagelijks beheer.”
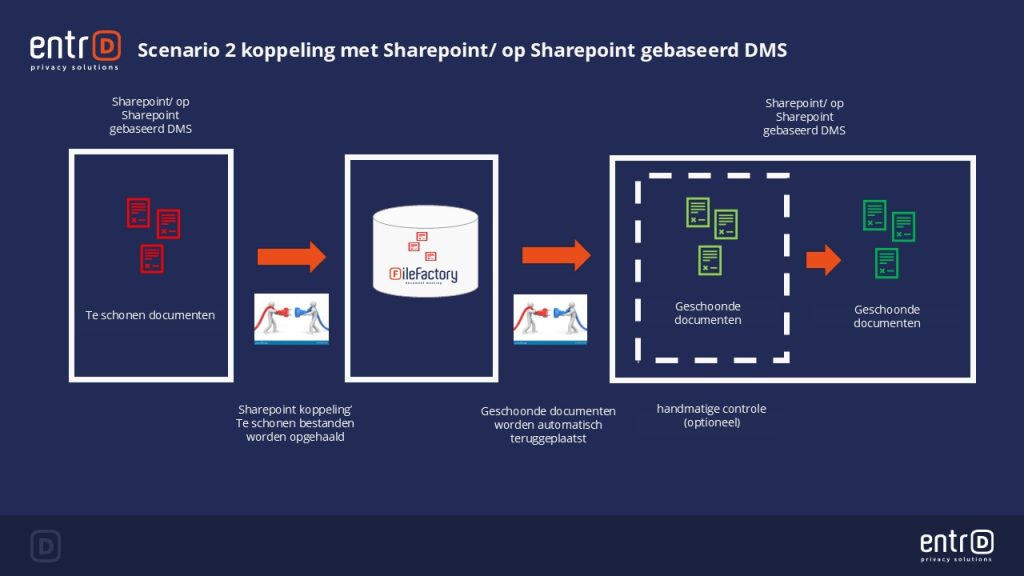
Afb. 2: FileFactory integratie mogelijk met o.a. fileshare, DMS en SharePoint (afb.)
FileFactory en Microsoft Purview
Mijn lezers zijn in het bijzonder geïnteresseerd in de meerwaarde van FileFactory ten opzichte van Microsoft Purview. Met Data Loss Prevention (DLP) kan je immers gegevens in documenten, mail en chat herkennen en daar acties aan verbinden, zoals rapporteren, waarschuwen, delen beperken. Ook kan je herkenning verbinden met classificatie (Sensitivitylabeling met Purview’s Microsoft Information Protection). En aan die labels is met Purview Datalifecyclemanagement / Recordsmanagement ook nog een bewaar- of vernietigingsmaatregel te verbinden. Anonimiseren van content is zeer beperkt, namelijk handmatig, mogelijk in Purview eDiscovery, dus dat laatste schiet zeker tekort.
Hoefman antwoordt: “Microsoft Purview en FileFactory zijn eerder complementair dan dat ze overlappen. In de praktijk zien wij dat Purview bijvoorbeeld gebruikt wordt om vast te stellen in welke documenten ongewenste gegevens zitten, waarna FileFactory die gegevens automatisch verwijdert. Daarnaast wordt FileFactory ook gebruikt voor documenten buiten Microsoft 365, zoals in DMS of op fileshare. Purview kan met DLP duiden welke documenten (mogelijk) data bevatten die gelakt en/of verwijderd moeten worden en FileFactory kan de output dan gebruiken om deze documenten te verwerken, zodat ongewenste informatie daadwerkelijk wordt gelakt en/of verwijderd.”
FileFactory in gebruik bij overheden
Ik zie op jullie site dat de oplossing DataFactory bij Nederlandse overheidsinstellingen, waaronder ‘40 gemeenten’ in gebruik is. Mag je iets meer vertellen over toepassing van FileFactory door klanten in dat overheidssegment?
“Hiervoor werken wij intensief samen met Pink Roccade”, aldus Hoefman. “Zij gebruiken een voorgeconfigureerde versie van DataFactory om gemeenten snel en eenvoudig te kunnen voorzien van een geanonimiseerde testomgeving voor iBurgerzaken. Op die manier voorkomen deze gemeenten dat ze persoonsgegevens gebruiken waar het niet nodig is. Maar ook in andere sectoren wordt DataFactory intensief gebruikt. Zo werken we in de sociale woningbouw met vooraanstaande softwareleveranciers die DataFactory inzetten om woningcorporaties te helpen om veilig en compliant te testen.” Hoefman verwacht dat EntrD daar binnenkort nog een partnership aan kan toevoegen met “één van de grootste Nederlandse softwareleveranciers van ERP software.”
Doorontwikkeling FileFactory
Hoefman legt uit dat Filefactory initieel ontworpen is om organisaties te helpen bij het vinden en verwijderen van ongewenste gegevens in elk type document en ongeacht de opslaglocatie. Maar dat EntrD momenteel achter de schermen hard werkt aan twee nieuwe toepassingen: Classificatie van documenten. Hierbij worden documenten altijd automatisch geclassificeerd op basis van de inhoud van het document; Ontdubbelen van documenten. Hierbij wordt automatisch gekeken of er meerdere kopieën van hetzelfde document aanwezig zijn. “Deze nieuwe modules zullen er voor gaan zorgen dat FileFactory organisaties ondersteunt bij het opschonen, classificeren en verwijderen van documenten, voegt Hoefman toe. “Deze twee features kunnen op zeer korte termijn worden verwacht.”
Verder in de toekomst volgt verdere integratie van AI binnen FileFactory waardoor ook gegevens die lastiger te traceren zijn, goed vindbaar worden, aldus Hoefman. “We willen ook functionaliteit toevoegen om gegevens automatisch op te sporen en te extraheren uit PDF-documenten, zodat deze bijvoorbeeld kunnen worden hergebruikt in een ander werkproces.”
Prijsmodel FileFactory: wat kost het?
Hoefman: “Zo transparant mogelijk: je betaalt een vast bedrag per gebruiker per maand en daarnaast betaal je voor het aantal verwerkte documenten. Dit laatste kan zowel op nacalculatie maar je kunt vooraf ook tegen een gereduceerd tarief een documentbundel inkopen. Extra modules zoals document classificatie en ontdubbelen zullen optioneel beschikbaar komen. Als overheidsorganisatie betaal je dus alleen voor wat je ook echt gebruikt.“
Tot slot
Is er nog iets dat jullie zelf kwijt zouden willen?
Van Dijk: “Wat mij steeds vaker opvalt in gesprekken en op beurzen: organisaties zoeken naar meer grip op waar hun data wordt verwerkt, onder welke jurisdictie. De huidige geopolitieke situatie komt op alle gebieden ter sprake. Tegelijk gaan gesprekken of presentaties bijna altijd over ‘cloud’, maar onvoldoende over datahygiëne. Terwijl juist dat laatste bepaalt of je echt compliant en audit-ready bent.”
Wat Peter van Dijk zegt onderschrijf ik graag. En – als ik nog mag aanvullen – uiteindelijk gaat het erom, in welke cloud of applicatie ook, dat organisaties heel snel praktisch aan de slag gaan en daadwerkelijk privacygevoelige informatie traceren, eventueel maskeren en waar mogelijk verwijderen.
—–
Tekst: ©Eric Burger
AI verklaring: deze blog is 100% handgeschreven, kop afbeelding Bing/Canva, schermafdrukken: EntrD